Les deux visages d’une révolution Budapest, 1956
70 ans après, la photographie d’un couple d’insurgés divise encore la Hongrie
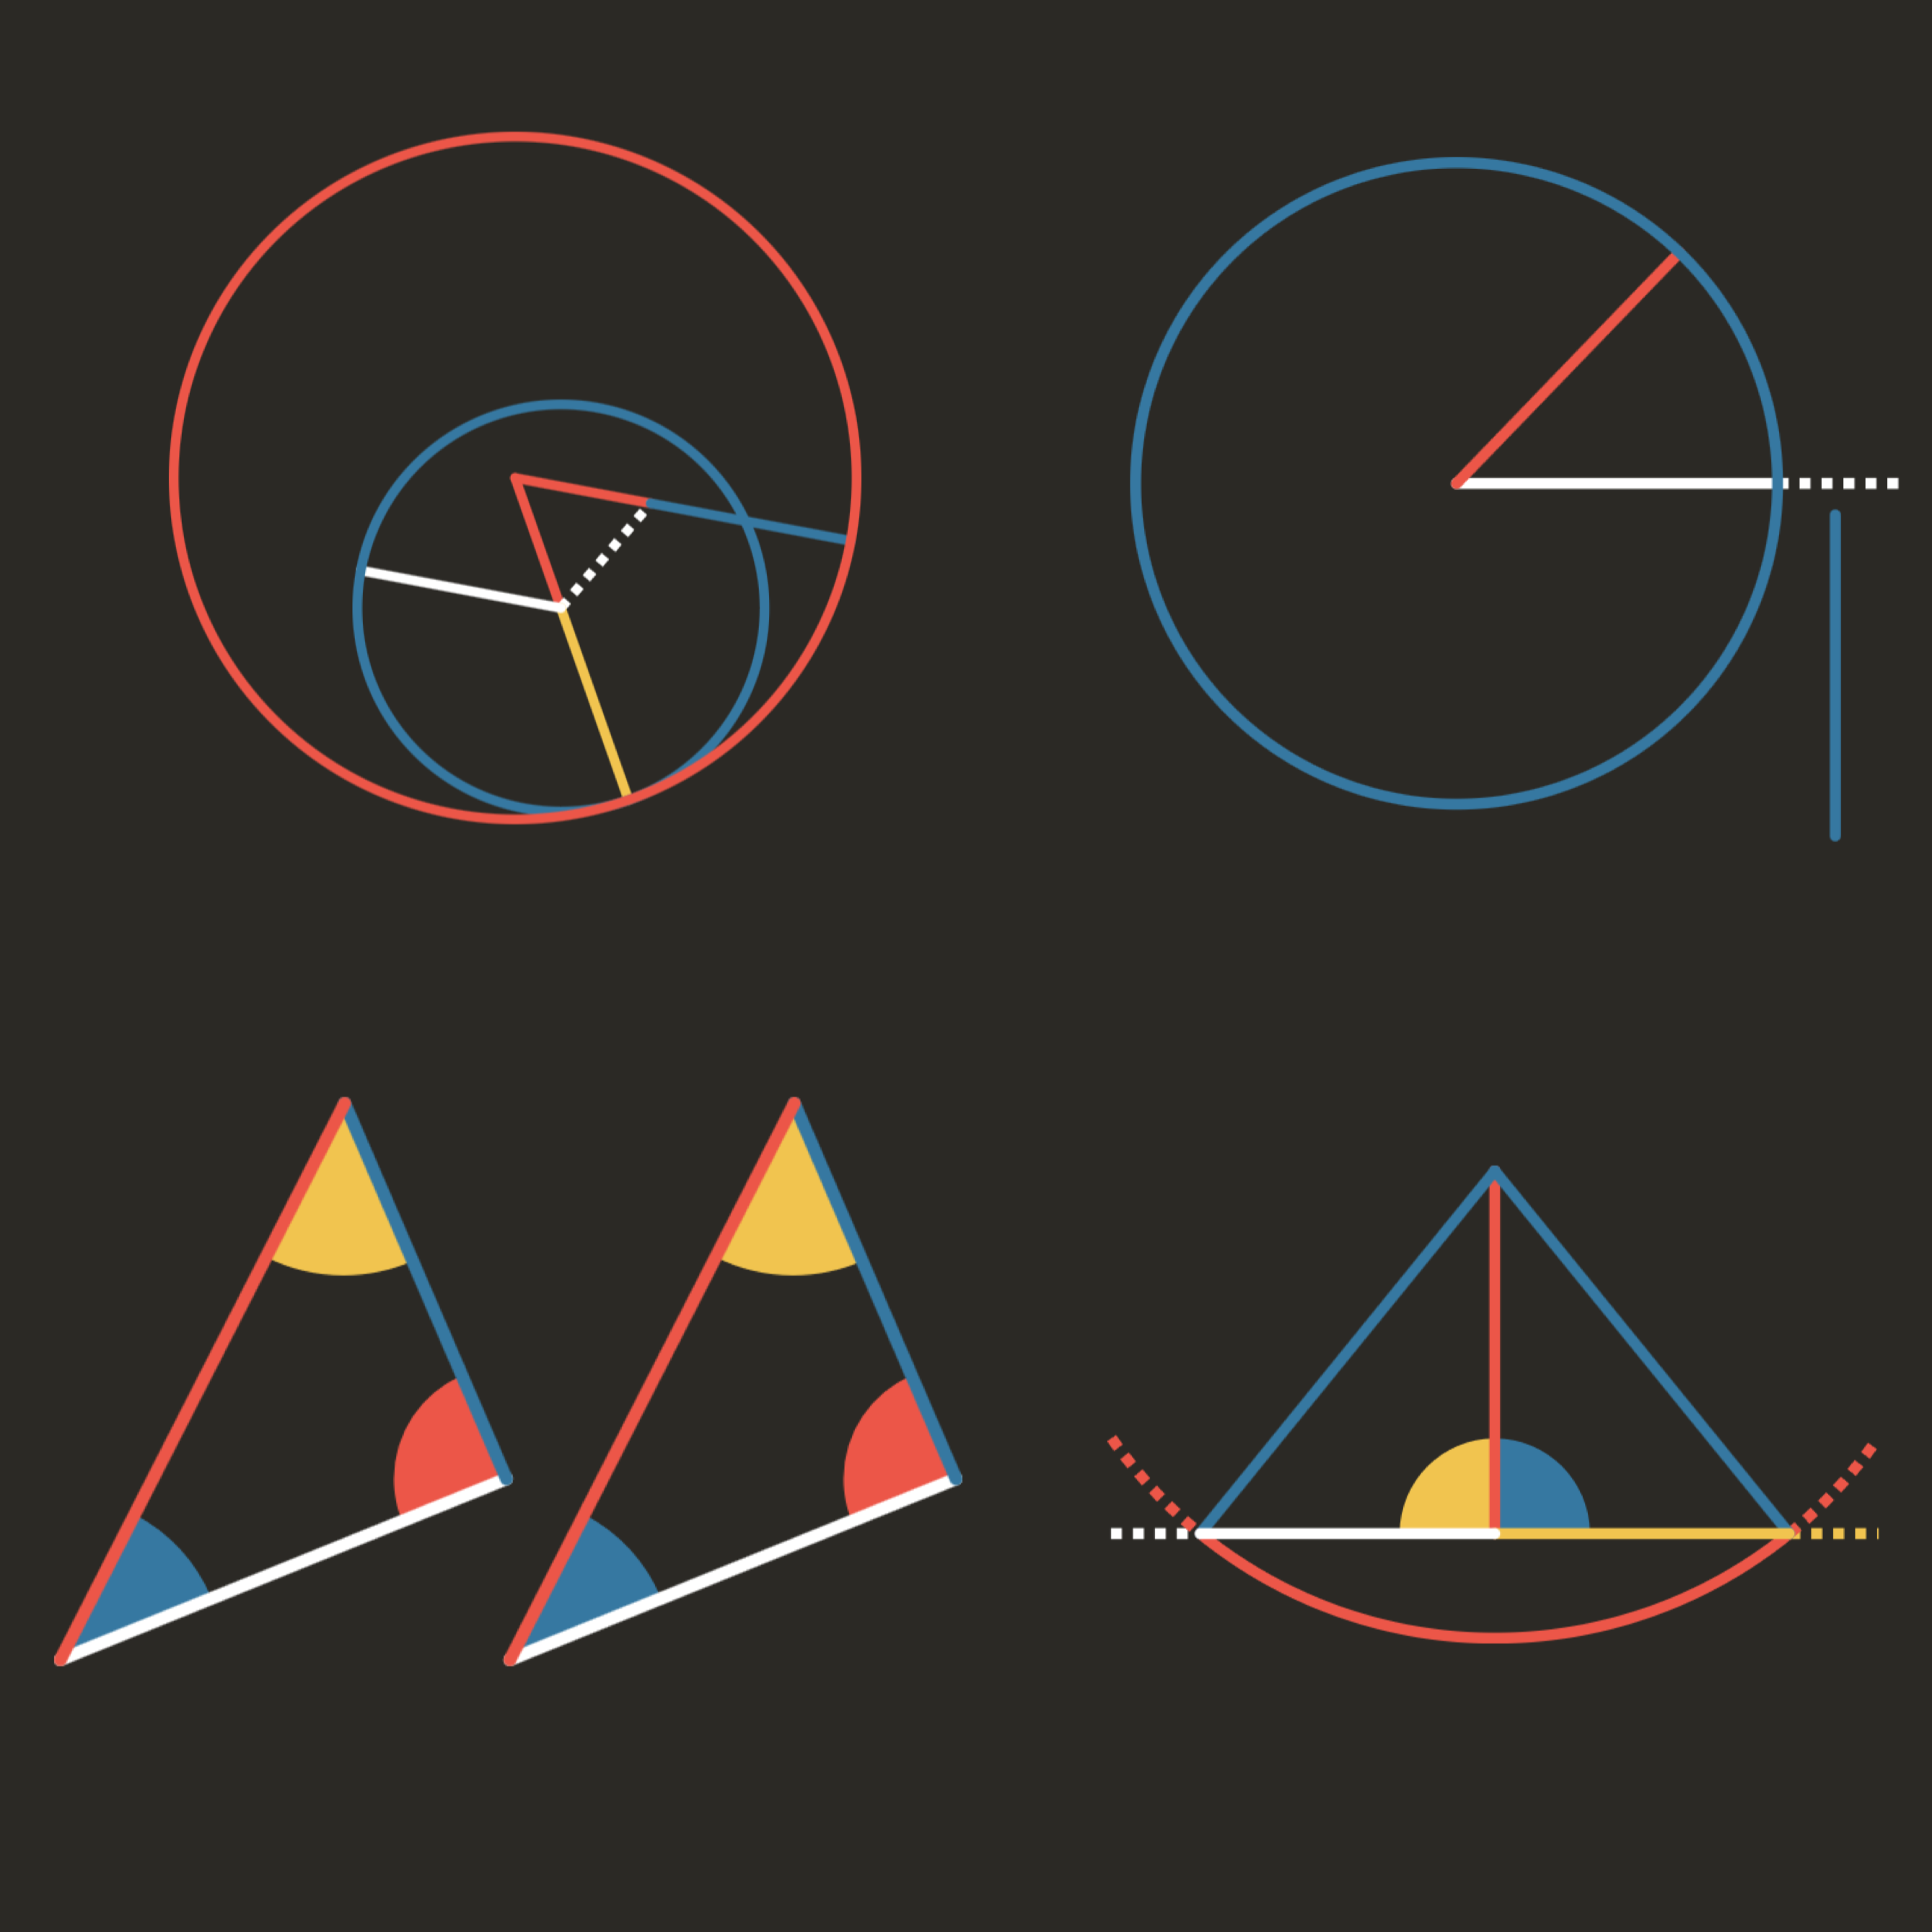
Auteur
Entretien avec
Hugo Duminil-Copin
Image
Oliver Byrne, Les Éléments d’Euclide (1847)
Date
Bouleversante, c’est le bon terme, au sens où c’est un changement de pratique, une forme de révolution. C’était d’ailleurs l’une des raisons pour lesquelles nous avions écrit ce livre avec Emmanuel Sander. Nous voyions l’intelligence artificielle progresser de mois en mois. Il y a encore quelques années, quand on demandait à ces systèmes combien font 5 + 3, ils répondaient n’importe quoi ; mais on voyait les choses progresser, et nous nous étions dit qu’il fallait écrire quelque chose qui explique ce qu’est la pratique humaine des mathématiques.
Ce que nous avons vu ces deux derniers mois, c’est le moment où les modèles les plus avancés, ceux qui ne sont peut-être pas encore accessibles au grand public mais dont disposent les grandes entreprises, sont devenus meilleurs que les meilleurs humains pour résoudre des conjectures, c’est-à-dire des problèmes ouverts, des questions qu’on ne savait pas démontrer. Cela fait maintenant deux mois que ça arrive. La veille de notre entretien sur France Culture, d’ailleurs, nous avions eu un premier coup de semonce dans mon domaine : la plus grande conjecture du champ venait d’être résolue. Puis il y a eu Navier-Stokes, l’un des problèmes du millénaire, estampillé comme l’une des plus grandes questions des mathématiques. Et puis, le 6 octobre, ce moment presque de bascule où l’on voit arriver une forme d’automatisation de la preuve, avec ces résultats publiés par OpenAI : plus de 700 d’un coup, 722 exactement.
Ça a été un bouleversement, parce qu’il faut bien comprendre que nous travaillons sur ces problèmes depuis très longtemps. Dans mon cas, ce sont des problèmes sur lesquels je travaillais depuis le début de ma carrière, depuis quinze ou vingt ans. On s’y attache émotionnellement. Ce qui fait qu’on se lance pendant des années dans des investigations pareilles, qu’on avance par petites touches, qu’on reste bloqué des mois sur une idée, c’est cet attachement : les émotions jouent un rôle moteur fondamental dans la recherche, quelle que soit la discipline. Et là, d’un coup… Je me rappelle, il était une heure du matin, je faisais défiler la liste et je voyais apparaître tous les problèmes, toutes les grandes questions que je me posais. Sur le coup, ça a été bouleversant, même si, bien entendu, cela offre aussi des perspectives exceptionnelles. C’est un changement brusque de l’état de la recherche.
Ils couvrent tous les domaines des mathématiques ; OpenAI a bien montré que son système était efficace partout, et pas seulement dans un petit domaine très réduit. Dans mon cas, cela concerne seize ou dix-sept problèmes sur lesquels je me posais vraiment des questions au jour le jour, des sujets très précis et très importants pour moi. Les autres sont importants pour d’autres personnes, mais je ne suis pas le bon expert pour en parler.
Ces seize problèmes sont très pointus, mais en gros, il s’agit de comprendre ce qui se passe quand la matière, ou un système, change brusquement de comportement. Vous chauffez de l’eau, à 100 degrés elle devient vapeur : il y a un changement brusque, on appelle ça un changement d’état. Mais ce peut être aussi une population saine dans laquelle arrive un virus, nous l’avons malheureusement vécu il y a quelques années : une épidémie se propage, le comportement de la population change brusquement, beaucoup de personnes sont infectées, beaucoup doivent être protégées. C’est ce type de choses que nous étudions dans mon domaine. Nous essayons de comprendre quels sont les phénomènes qu’on appelle universels, c’est-à-dire ceux qu’on retrouve systématiquement dans ces changements de comportement, quelle est la bonne façon de les décrire, quelles sont les bonnes quantités.
Je ne sais pas si beaucoup s’en souviennent, mais au début du Covid, il y avait cette question des clusters, et une forte volonté politique de réduire leur taille. L’effet de cluster relève de ce qu’on appelle les effets métastables : dès qu’un cluster atteint une certaine taille, il ne peut plus être arrêté, il va se répandre et infecter toute la population. On trouve ce phénomène dans beaucoup de transitions de phase, de changements brusques de la matière. Comme il y de nombreux phénomènes différents, il y a beaucoup de modèles, qui soulèvent des difficultés mathématiques différentes, et les résultats du 6 octobre ont démontré quantité de choses sur ces différents phénomènes.
La première chose que nous avions comprise dès le printemps, c’est que beaucoup de gens rient ou s’inquiètent, selon leur point de vue (les deux se défendent), des hallucinations que ces grands modèles de langage, comme ChatGPT ou Claude, peuvent avoir. Ils disent des choses fausses, ils inventent. Nous nous sommes donc demandé un moment comment ces modèles pourraient devenir bons en mathématiques, puisque dans cette discipline, dire quelque chose de faux est catastrophique : toute la démonstration s’effondre. Mais depuis des mois déjà, ce que produisent ces modèles est vérifié par l’ordinateur lui-même, qui contrôle la cohérence logique. Ces modèles ne font donc plus vraiment de fautes. Ils en font de temps en temps, mais c’est très rare, pas plus que les humains. Il faut vraiment se défaire de l’idée que ces preuves sont fausses. Il y en aura peut-être quelques-unes qui s’effondreront, car la machine se fonde aussi sur un corpus de textes écrits par des humains et peut donc faire des erreurs, mais c’est très rare : elle est aussi juste que les humains.
Deuxième chose que nous avions remarquée assez tôt, en avril (dans mon cas, j’ai réalisé cela parce que la foudre était tombée assez près de nous) : l’intelligence artificielle est très performante pour faire des analogies à grande distance. C’est un sujet dont nous parlons beaucoup dans le livre. Bien sûr, la logique est le ciment des mathématiques ; une preuve doit être logique au bout du compte. Mais pour trouver cette preuve, il faut faire des analogies, être créatif et comprendre les liens entre les choses. Or, l’intelligence artificielle est par définition encyclopédique : elle n’a aucune difficulté à connaître tous les articles mathématiques. Moi, j’en suis incapable, j’ai une très mauvaise mémoire, une mémoire humaine. Vers avril, nous avons commencé à voir des articles dans lesquels figurait une analogie à longue distance qu’aucun humain n’avait remarquée auparavant. En revanche, la preuve était encore très simple. C’était comme quelqu’un de très fort pour trouver le bon livre, l’ouvrir et dire : « Regardez, c’est ça qu’il faut faire », mais qui n’avait pas encore la capacité de construire des preuves élaborées.
Troisième point, arrivé plutôt à l’automne : ces intelligences artificielles sont parvenues à créer des preuves et à devenir de bons architectes mathématiques. Quand un mathématicien démontre quelque chose, c’est un travail d’architecture à part entière. Il faut ensuite assembler les morceaux, mais trouver l’architecture est la partie la plus créative. Et les intelligences artificielles y sont parvenues cet automne, avec des preuves très élaborées. Dans mon domaine, il y a des preuves de mille pages. C’est très rare en mathématiques. Pour donner un ordre de grandeur, j’ai écrit 3 500 pages dans toute ma carrière, et un article fait généralement cinquante pages, parfois moins, parfois plus.
Dernier point : l’automatisation d’octobre, qui est une forme de systématisation. Ils ont publié 722 articles, mais ils ont tenté de résoudre 4 000 problèmes. Ils essaient partout ; parfois, ça marche, c’est super, et dans les autres cas, ça ne marche pas. C’est une pratique qui diffère un peu du fonctionnement humain, ce qui est plutôt une bonne chose, car cela signifie que la machine viendra compléter les capacités humaines. De ce point de vue, le fait que la preuve soit un peu différente n’est pas plus mal.
C’est un point important. Je ne fais pas partie de ceux qui trouvent ces textes totalement illisibles. Ils ne sont pas faciles à lire et je pense qu’il y a une volonté de ne pas trop humaniser l’écrit afin d’éviter les erreurs. En effet, quand on demande à ces systèmes d’écrire de manière plus pédagogique, ils n’arrivent pas encore à le faire sans se tromper. Ils simplifient trop. Il y a donc un enjeu. Mais cela ne me dérange pas outre mesure, car la clef, au fond, c’est la compréhension des preuves. Rendez-vous compte du volume, rien que pour les seize articles qui me concernent sur 722 : à l’échelle de l’ensemble, ce sont des dizaines de milliers de pages en octobre, et ce seront bientôt des centaines de milliers. Si personne ne les comprend, si personne ne les lit, c’est comme si un arbre, ou plutôt un gros bosquet, était tombé dans la forêt sans que personne ne le sache. Il faut évidemment que des gens soient capables de comprendre tout cela et d’en tirer des idées.
Quand ces preuves sont mal écrites, c’est presque un travail d’archéologue : il faut faire des fouilles pour parvenir à trouver les gemmes dans un texte qui n’est pas optimal. Ce n’est peut-être pas si mal d’ailleurs : la joie de découvrir la gemme, de pouvoir la polir, de réfléchir à la façon dont elle pourra être réutilisée et aux questions à poser à la machine est passionnante. Pour ma part, j’éprouve une forme d’excitation intellectuelle à fouiller ces textes pour trouver les passages qui ont vraiment de la valeur mathématique.
Je ne suis pas d’accord : je trouve qu’il y a des idées extrêmement élégantes dans les articles que j’ai lus. Si ces idées avaient été l’œuvre d’humains, j’aurais été estomaqué. On ne peut donc pas réduire cela à un défaut d’élégance. La chose fondamentale, c’est qu’il y a un équilibre à trouver entre la logique, qui constitue la partie formelle des mathématiques (ce qu’on appelle d’ailleurs le formalisme), et l’intelligibilité pour les êtres humains. Cet équilibre n’est pas simple à trouver. On peut, par exemple, créer des preuves purement formelles ; ces intelligences artificielles en sont capables, ce sont des formalisations dans le langage Lean. Ces formalisations sont purement logiques et montrent que tout s’enchaîne logiquement. Sauf que ce sont des centaines de milliers de pages pour des énoncés qui nous semblent totalement évidents intuitivement. C’est illisible. Il faut donc trouver un meilleur équilibre, et c’est ce que fait la machine quand elle essaie de produire des preuves en langage humain : trouver la bonne élégance. C’est comme si l’on avait l’idée d’un super thriller : il y a des milliers de façons de l’écrire, certaines n’accrocheront pas l’attention, d’autres révéleront mieux telle ou telle chose. Il existe une multitude de façons d’écrire une preuve. Il ne faut pas penser qu’une preuve est quelque chose de figé qui n’aurait qu’une seule forme.
Aujourd’hui, c’est vrai, ce sont des textes difficiles à lire, et peut-être que ça restera toujours un peu comme ça, puisque par définition, la machine fonctionne et crée des preuves différemment de nous. Ce qu’elle écrit est différent de notre compréhension. D’ailleurs, ce qui serait bien pour moi ne l’est pas forcément pour mon doctorant ou ma collègue chercheuse. Chacun a ses sensibilités. C’est à nous de nous emparer de ces textes pour créer des versions transmissibles et communiquer ces idées plus largement.
Je ne suis pas spécialiste de ce domaine, je ne vais donc pas me positionner là-dessus. Ce que je peux dire, c’est que la lecture d’un texte mathématique est très lente. Il ne faut pas imaginer qu’on récolte deux mille pages et qu’on les lit d’une traite : même dix pages peuvent prendre des semaines. Même pour les problèmes très proches de mon domaine, je n’ai lu pour l’instant qu’un seul article que je comprends. En fait, j’en ai lu deux, parce que j’en avais écrit un en parallèle : j’avais résolu le problème avant l’IA, et en le lisant, j’ai reconnu les mêmes trames, les mêmes idées, au point de me dire que je n’avais même pas besoin de le lire. Mais ce sera un processus extrêmement lent. Quand les personnes disent qu’on n’a plus besoin de mathématiciens, j’attire l’attention sur le fait que nous ne sommes que quelques dizaines à avoir acquis l’expertise nécessaire pour comprendre ces problèmes, et que cela va nous prendre des mois et des mois, même avec cette expertise. Pour certains de ces problèmes, je n’ai pour l’instant aucune idée de la façon dont la preuve fonctionne ; pour d’autres, je les ai lus en diagonale et je les comprends un peu.
Il y a une chose qui a été un peu violente pour moi : nous avancions très bien dans notre domaine et nous étions à l’interface de plusieurs autres. Nous avons donc été doublement touchés, car nous étions proches de nombreuses grandes questions. Souvent, ce qui nous manquait se trouvait de l’autre côté. Je suis probabiliste de formation ; l’algèbre, je peux l’apprendre, mais ce n’est pas ma spécialité, et devenir suffisamment expert dans ces domaines était très difficile pour moi. L’IA, encyclopédique, a su aller chercher ces outils. Elle a repris nos idées, elle s’est fondée sur ce que nous avions écrit, et cela ne me pose aucun problème. Mais nous avons été très touchés aussi parce que nous n’étions pas loin.
Dans le cas de la quasi-hypothèse de Riemann, si je comprends bien, les gens ont été extrêmement surpris et certaines des idées produites sont peut-être plus surprenantes que celles que l’IA a utilisées dans mon domaine. Pour notre part, je suis assez confiant : nous allons très bien comprendre ces problèmes, car c’est, au fond, un prolongement naturel, mais extrêmement impressionnant, je dois le dire, de ce que nous faisions. Dans d’autres domaines, il y a peut-être des idées tellement étonnantes qu’il faudra beaucoup de travail pour les comprendre. Quant à une éventuelle erreur, je ne l’exclus pas, mais je ne suis pas spécialiste de ce domaine. Je crois que la preuve a été formalisée en Lean, donc normalement, il n’y a pas de faute logique. Mais on ne sait jamais : même sans faute logique, elle peut se fonder sur un résultat faux ou mal interpréter un texte humain. Il faudra demander aux experts.
Cela, en revanche, est vrai. Je pense que même les textes de notre domaine, dans leur état actuel, n’auraient été acceptés par aucune revue. Je le vois plutôt comme si on nous disait : « Voilà, vous avez maintenant des données, on vous envoie plein de données, des preuves très brutes, et c’est à vous de les décortiquer, de les transformer en vrais arguments intelligibles pour l’être humain. » C’est une tâche qui va demander de la créativité, de l’émotion, de la collaboration, exactement comme la recherche de nouvelles preuves le requérait auparavant. Le changement, c’est que nous ne trouvons plus nous-mêmes les nouvelles preuves, ou du moins qu’il faudra probablement le faire avec l’IA. Il y aura peu d’arguments totalement nouveaux produits purement par des humains ; il y en aura, mais probablement à la marge. Prétendre le contraire n’a pas de sens.
Mais ce travail reste à faire. Ce matin, avant que nous parlions, j’étais en train de finaliser la réécriture d’une preuve qui, selon moi, était totalement illisible dans sa première version. Elle avait déjà été retravaillée par un premier collègue qui avait réalisé un excellent travail de réécriture. Ensuite, une équipe chinoise s’en est servie pour améliorer le résultat en utilisant l’IA, mais la preuve n’était toujours pas beaucoup plus simple ni lisible. J’ai donc eu besoin de faire ce travail, et j’ai maintenant une preuve toute courte qui me plaît, que je comprends et que je vais partager avec les autres. Ce processus ne s’arrête pas au moment où certains prétendent : « C’est bon, fermez boutique, on a la preuve. » Cela n’a aucun sens. Je reprends la même image : ce n’est pas parce qu’un arbre est tombé quelque part qu’on peut s’en servir.
Plusieurs choses. D’abord, un mathématicien, à l’instar d’un jeune enfant, arrive avec ses propres intuitions. Quand je commence à lire un article, j’ai des intuitions sur le problème, des représentations mentales qui me viennent et qui sont le fruit de mon expérience. Certaines sont mathématiques, d’autres non. J’arrive aussi avec mes limitations. Je ne suis pas quelqu’un qui abstrait particulièrement bien ; j’ai des collègues bien plus aptes à manipuler des objets abstraits. Je viens avec cette limite. J’ai également une très mauvaise mémoire : retenir les notations est un véritable enfer pour moi. J’aborde donc la lecture de la preuve avec mes limites, exactement comme un jeune enfant à qui l’on parle de soustraction va penser à « ôter » : quand il arrive à l’école, il a déjà plein d’intuitions qui viennent du monde extérieur. Il va falloir naviguer avec ces intuitions, parfois trompeuses, parfois au contraire de très bons leviers pour comprendre de nouvelles choses. À partir de là, il s’agira de développer de nouvelles intuitions, de progresser dans les concepts, d’acquérir une nouvelle compréhension de certains concepts, de certaines intuitions, de certains faits.
C’est un processus très lent. Je ne suis pas neurologue, mais j’ai presque l’impression qu’il s’agit d’une transformation de nos réseaux de neurones, avec de nouvelles connexions qui se créent. Cette modification de notre vision du monde est extrêmement lente et ne peut être que lente. L’IA n’offre pas de solution miracle permettant de se passer de ce processus d’apprentissage. C’est d’ailleurs là le vrai danger : au-delà du fait que l’IA menace certaines activités, ce qui est beaucoup plus pernicieux, c’est qu’elle nous fait oublier pourquoi nous les pratiquons. Quand je cherche à comprendre un article, je peux bien sûr demander à l’IA de m’aider sur certains points. Au tout début, je le faisais et je n’avançais pas. Mais plus récemment, en particulier depuis avril, je me suis dit : « Non, je vais revenir à ce que je faisais quand j’étais jeune. » Étudiant, je réécrivais tout par moi-même. Si je n’avais pas réécrit une preuve, c’est que je ne la comprenais pas.
Avec mon vocabulaire, d’abord en m’aidant du texte. Je paraphrasais presque, mais en ajoutant des détails à certains endroits et en enlevant d’autres, parce que tel calcul ne me posait pas de problème ou que j’avais déjà rencontré telle idée ailleurs. Dans une deuxième étape, j’essayais de réécrire sans support. Tant que je n’y arrivais pas, c’est que je n’avais pas compris.
C’est drôle, je crois que j’avais presque oublié cette pratique. L’IA me l’avait fait oublier : j’avais tendance à lui demander d’ajouter des détails ici ou là, mais en fait, je n’apprenais rien. Je ne retenais rien. Elle ajoutait des détails, mais comme ce n’était pas moi qui les avais trouvés, je ne parvenais pas à apprendre. J’ai donc complètement arrêté d’utiliser l’IA pour lire des articles produits par l’IA, car c’était contre-productif. Et ce qui est vrai pour moi l’est aussi pour n’importe quelle personne qui apprend les mathématiques ; j’attire l’attention là-dessus, en particulier pour les jeunes. Cette illusion d’instantanéité aura un effet néfaste, car le cerveau humain n’apprend pas instantanément. Quelle que soit la discipline, et c’est ce que nous décrivons dans le livre, il doit passer par ce processus de confrontation au réel. Dans le cas des mathématiques, il s’agit de confronter nos pensées, notre psychologie, au monde formel.
Pour moi, il y a deux risques, dont un majeur. Le risque majeur est de tomber dans l’illusion qu’il faut produire le plus de résultats possible à l’aide de l’IA, sans que ceux qui les produisent fassent l’effort de s’assurer qu’ils les comprennent eux-mêmes et qu’ils puissent les transmettre. En effet, si l’on fait cela, un découplage va se créer : une immense bibliothèque de résultats mathématiques que personne ne comprendra. Si nous en arrivons là, nous aurons un problème. Nous ne pourrons pas être certains qu’il n’y ait pas d’erreurs ou de choses dangereuses dedans. Nous n’aurons aucun contrôle sur ce qui se passe. Et nous ne pourrons plus poser les bonnes questions, car pour poser une question, il faut d’abord comprendre.
C’est ce que je réponds toujours aux jeunes, de plus en plus nombreux à me demander à quoi ça sert d’apprendre à l’heure de l’intelligence artificielle, si celle-ci devient plus performante que les humains dans quasiment n’importe quelle tâche intellectuelle. Je leur dis : rien que pour poser cette question, il a fallu que vous appreniez jusque-là ; vous n’auriez pas pu la poser sans tout un apprentissage tout au long de votre vie. L’apprentissage permet de grandir, de se développer, de devenir la personne que l’on est. C’est vrai au niveau individuel, et c’est vrai au niveau de l’humanité. Si l’on n’apprend plus les mathématiques, on ne pourra plus poser les bonnes questions ; on se retrouvera dans Le Guide du voyageur galactique, avec une réponse dont on ne comprend même pas la question, le fameux 42. Voilà le premier enjeu : la perte de contrôle. C’est vrai pour les mathématiques, mais ce sera vrai pour toutes les sciences, et d’autant plus problématique quand il y aura des questions de santé publique ou potentiellement militaires. Là, il y a de vrais dangers. Pour les mathématiques, il y a déjà un vrai danger en matière de sécurité, d’algorithmique, de tout ce qui touche à la cryptographie : on peut y perdre le contrôle.
Le second danger est plus subtil et explique pourquoi, à titre personnel, je n’utilise pas l’IA dans ma pratique créative et pourquoi je continuerai à faire ainsi : on ignore ce que deviendra la créativité artificielle si elle ne se nourrit que d’elle-même. Des questions se sont posées lorsque les intelligences artificielles ont commencé à se nourrir de leurs propres textes : on a constaté un appauvrissement du langage, un renforcement des stéréotypes et une standardisation croissante des textes. Est-ce que nous voulons cela pour les sciences en général ? C’est une vraie question. Une frange de la communauté mathématique soutient qu’il reste une place pour la pratique humaine de la résolution de problèmes et de la créativité. Même si l’on pense que l’immense majorité de la production viendra des intelligences artificielles, cette part humaine fournira en quelque sorte l’essence de la nouveauté et de l’originalité qui permettra de nourrir ces machines. C’est aussi pour cette raison que je lis les articles générés par l’IA sans l’utiliser : je veux que ma compréhension soit humaine et qu’elle soit peut-être différente de ce que pourrait générer une intelligence artificielle.
Voilà donc les deux dangers : la perte de contrôle et, peut-être, l’assèchement. Nous sommes encore aujourd’hui dans une phase de transition, précisément parce que la machine se nourrit de tout ce que nous avons produit en tant qu’êtres humains. C’est impressionnant : dans mon cas, je suis cité des dizaines et des dizaines de fois, et je vois très bien que ce sont les idées que nous défendons au sein de la communauté depuis des années. Aujourd’hui, il n’y a pas de problème de créativité, car tout cela s’alimente de ce que nous avons fait. Mais attention à ce danger de standardisation et d’assèchement. Il faut préserver une part humaine.
Je comprends pourquoi c’est difficile à lire. Mais je ne pense pas que ce soit déjà dû à un phénomène de circularité. Je pense que c’est plutôt dû au fait que le fonctionnement de ces réseaux de neurones est assez différent du nôtre, ce qui est une bonne nouvelle. Typiquement, et vu ce que j’ai dit précédemment, autant vous dire que je suis mal barré : ils adorent introduire des notations. C’est probablement parce que, dans le langage informatique, il n’est absolument pas gênant d’avoir ce qu’on appelle une macro, c’est-à-dire un symbole qui remplace une commande, un texte court, une formule ou une certaine notation. Pour l’ordinateur, c’est presque typique d’un programme d’avoir tous ces remplacements. Mais pour le cerveau humain, c’est horrible. Je préfère largement, même si cela prend trois lettres de plus, avoir la chose écrite explicitement plutôt qu’une notation dont je vais forcément oublier dix pages plus loin et que je vais devoir retrouver.
Cette écriture complexe à lire vient en grande partie de là. Elle provient également du fait que les termes utilisés ne sont pas les termes standards : on se retrouve à lire un texte qui mobilise des concepts que l’on connaît, mais pas sous le nom que l’on leur connaît. Imaginez cela dans un autre contexte : cela crée des dissonances cognitives. On commence à vous parler d’une cravate, sauf qu’on l’appelle « un bout de tissu qui pend du cou », ou quelque chose de moins explicite encore, « un quadrilatère en tissu ». Et vous vous demandez : est-ce vraiment une cravate ? Est-ce autre chose que j’aurais manqué ? Ce type de choses s’accumule et rend la lecture difficile. Mais je ne pense pas que les concepts sous-jacents et les idées développées soient eux-mêmes complexes et mal introduits. Je pense plutôt que c’est la forme qui est encore extrêmement perfectible. Ce sera notre travail : l’IA va s’améliorer et pourra nous expliquer des choses de plus en plus compliquées ; le facteur limitant restera toujours l’humain.
À mon avis, la question de l’abstraction n’est pas fondamentalement modifiée par l’intelligence artificielle. De la même manière que nous, êtres de chair et de sang, produisons de l’abstraction, il n’y a pas d’obstacle à ce qu’une intelligence artificielle, faite de silicium ou d’autres matériaux construise des concepts abstraits. Aujourd’hui, je dois dire que dans les preuves que nous avons vues, la capacité à créer des théories unifiées n’est pas encore là. Ce sera-t-il le mois prochain ? Peut-être, mais je ne m’avance pas sur l’avenir. Nous n’avons pas encore vraiment vu émerger des concepts unifiants. C’est probablement la prochaine étape.
Je ne vois en tout cas pas d’obstacle clair à ce qu’elle puisse le faire à l’avenir. Pour l’instant, elle réussit vraiment à créer des liens entre ce qui existe déjà. D’un certain point de vue, c’est aussi ce que nous faisions auparavant ; de tous ces liens et de toutes ces analogies, nous voyions émerger des concepts unificateurs. Les mathématiques, c’était l’art de formaliser ces analogies, ces liens que l’on trouvait, ces rapprochements entre des choses qui se ressemblaient. On essayait d’introduire le concept unifiant qui permettait d’en parler de façon rigoureuse. En effet, le danger de l’abstraction dans la vie de tous les jours, c’est que plus on monte en abstraction, plus nos concepts deviennent flous. L’idée des mathématiciens était d’éviter cet effet en restant extrêmement précis à chaque étape.
Quels que soient les domaines, il y a eu cette période de progression presque horizontale où, à l’aide des idées dont on dispose, on développe de plus en plus de matériel et de théorèmes. On voit alors apparaître des connexions de plus en plus clairement, jusqu’à ce qu’une personne ou un groupe de personnes crée le concept unifiant qui permet de réunir tout cela. Grothendieck en est l’un des exemples les plus frappants, mais il y a eu beaucoup d’autres. Emmy Noether l’a fait avec les symétries et les invariants, ce qui a eu un impact énorme en physique. Kolmogorov a développé une théorie des probabilités qui a permis d’unifier quantité de choses, alors que l’on pratiquait les probabilités depuis déjà trois cents ans. Ce processus de découverte de concepts unificateurs ne se manifeste pas dans le corpus actuel produit par l’IA. Mais je ne vois pas de raison fondamentale pour que la machine, du moins si elle est guidée par l’humain, ne devienne pas un moyen très efficace de les trouver. En tout cas, je pense que l’IA et l’humain ensemble seront très efficaces dans ce domaine. L’IA deviendra-t-elle si forte qu’elle n’aura quasiment plus besoin d’humains pour trouver ces concepts ? Peut-être. Mais il faudra encore que les humains s’emparent de ces nouveaux concepts.
En effet, l’un des impacts les plus fondamentaux des mathématiques n’est pas le dernier petit théorème démontré. Ce sont, au fond, ces concepts unificateurs qui mettent des dizaines, parfois des centaines d’années à devenir si efficaces et compris qu’ils deviennent un savoir collectif. C’est le cas du zéro, des nombres négatifs et de la notion de droite : tout citoyen sait ce que c’est. On pourrait penser que la droite ne sert qu’à faire de la géométrie. Mais non : on s’en sert constamment en architecture et en urbanisme ; la perspective, c’est une histoire de droites. Beaucoup de notions mathématiques, comme l’algorithmique et, plus récemment, les fractales, sont en train de devenir des outils cognitifs pour l’ensemble de la population, mais cela passe par un processus extrêmement lent. Quand bien même la machine serait capable de trouver des concepts unifiants, il faudrait encore travailler à les rendre appropriables par la population.
Ces problèmes se sont peut-être révélés plus difficiles que prévu. On attribue a priori une certaine difficulté à un problème, qui s’avère parfois moindre et parfois plus importante. La machine a navigué là-dedans, et certains problèmes se sont révélés plus ardus que d’autres. Dans mon domaine, nous avons été surpris de voir à quel point nous étions proches de la solution pour beaucoup de problèmes : certains nous semblaient beaucoup plus difficiles qu’ils ne l’étaient en réalité.
Mais c’était aussi vrai entre humains. L’un des plus beaux moments de ce dernier mois, pour moi, a été mercredi dernier, quand des collègues chinois ont mis en ligne une preuve qu’ils avaient trouvée depuis longtemps déjà, concernant l’un des problèmes démontrés par l’IA. Une nouvelle preuve qu’ils avaient trouvée il y a un an, mais il faut du temps à l’humain pour écrire. Cela m’a émerveillé parce que cela m’a rappelé qu’à travers les succès de nos congénères, j’emploie volontairement ce terme, c’est un peu de nous qui grandit aussi. Il y a une certaine forme de fierté quand un grimpeur arrive au sommet d’une grande falaise du Yosemite. Je ne suis pas grimpeur, mais je regarde ce qu’il fait et je me dis : « Waouh, il y a des humains qui peuvent faire ça. » Quand une chanteuse produit telle chose, il y a quelque chose qui nous fait grandir. J’ai trouvé cela très impressionnant de voir qu’ils avaient résolu ce problème et de me dire que l’être humain est quand même incroyablement créatif.
Pourquoi dis-je cela ? Parce que c’était un beau moment pour moi, mais aussi parce que j’avais l’impression que ce problème était loin d’être résolu. Je n’avais aucune intuition à ce sujet ; pour moi, c’était presque de la science-fiction. Et, de l’autre côté de la Terre, des humains étaient en train de comprendre pourquoi cela fonctionnait et d’écrire la preuve. On se trompe donc parfois sur la difficulté d’un problème, et parfois à l’inverse : on se lance dans un problème, et il s’avère en fait beaucoup plus compliqué. Parmi les problèmes que nous, humains, avions jugés importants et probablement faisables, la machine en a essayé et s’est rendue compte qu’ils étaient plus difficiles que prévu.
Ensuite, elle va progresser en puissance. Et les humains parviendront, je pense, à l’utiliser de façon plus efficace, car aujourd’hui, tout cela est très automatique. Il faut bien comprendre que chez OpenAI, personne ne comprend ces problèmes, ou alors peut-être quelques mathématiciens qui en comprennent quelques-uns. Pour la plupart des problèmes, l’entreprise elle-même serait totalement incapable d’expliquer ses résultats à des mathématiciens. Il n’y a pas de collaboration. C’est plutôt : on vous donne ça, on vous en charge le dos, et à vous de le porter au sommet de la montagne. J’espère de tout cœur que l’avenir sera celui de la collaboration et que cet outil deviendra efficace, et non pas une sorte de remplacement, comme on l’a un peu suggéré en octobre : « On vous explique qu’il n’y a plus besoin de mathématiciens, regardez comme nous sommes forts. » J’espère qu’ils ont eux-mêmes compris leur erreur à ce niveau et que nous allons maintenant imaginer quelque chose de beaucoup plus interactif. J’espère aussi que cet outil sera au service de la communauté plutôt qu’un danger, comme il a été présenté ce dernier mois.
Oui, c’est le modèle lui-même qui a recherché automatiquement dans la littérature des problèmes présentés comme majeurs pour tenter de les résoudre. Il n’y a même plus personne pour « prompter », comme on dit. Personne ne demande : « Pourriez-vous répondre à cette question posée par telle personne, s’il vous plaît ? » Non, c’est vraiment totalement automatique. Je pense que l’étape suivante sera que des experts s’emparent eux-mêmes de ces outils. Cela devrait décupler les possibilités, car l’expertise humaine vient compléter celle de la machine, et permettre d’avancer beaucoup plus rapidement. Encore faut-il qu’on ait accès à ces modèles. Et cela coûte de l’argent ; il y a une dépense écologique, une dette écologique. La question de l’usage de ces outils est donc tout à fait pertinente. Certains les utiliseront, et d’autres comme moi continueront à travailler sans IA, afin de compléter, en quelque sorte, nos capacités et notre savoir-penser, que nous ne voulons pas entièrement déléguer à la machine.
Notre travail a toujours été d’être les premiers maillons de cette chaîne humaine de compréhension. Peut-être que la façon dont nous parlons des mathématiques, à travers les prix et les grandes conjectures, a fait oublier cette dimension profondément humaine, voire scientifique, de la pratique mathématique. Pour ma part, je l’ai toujours considérée ainsi, et c’est pour cette raison que j’ai écrit ce livre avec Emmanuel Sander : notre objectif était de rappeler cette dimension extrêmement humaine de la pratique. De ce point de vue, je ne peux imaginer aucun cas où cette part du métier serait profondément transformée ou remplaçable.
Le seul cas que je pourrais imaginer serait celui où l’on enlèverait cet axiome de base, cette hypothèse fondamentale : nous voulons qu’il y ait des humains qui puissent transmettre ces idées, car nous pensons qu’elles sont utiles aux gens dans la vie de tous les jours. Je pense sincèrement que si nous vivions dans une société qui nie cet axiome, qui nie l’importance du contrôle et de la compréhension humaine, l’idée que la science doit être au service de l’humain et non une simple boîte noire, et que l’on accepte que toute notre connaissance vienne d’une machine, alors nous serions confrontés à une difficulté bien plus grave que la question de savoir ce que deviennent les mathématiciens et les mathématiciennes. En effet, à partir du moment où l’on n’apprend plus, on ne peut plus se poser ces questions. Nos capacités cognitives déclineront donc petit à petit ; nous connaîtrons une régression de notre faculté de penser, et le problème sera bien plus large que celui des mathématiques.
Rappelons-nous encore une fois ceci : les mathématiciens sont les premiers à comprendre certaines idées mathématiques. Ils les transmettent ensuite à d’autres scientifiques et enseignants, qui à leur tour les transmettent à d’autres. Et à chaque étape, il y a un filtre : on choisit les idées les plus utiles, les plus marquantes. C’est un processus de sédimentation. Si l’on coupe en haut, si l’on enlève la première étape, ce sont mécaniquement ceux d’en dessous qui devront commencer à comprendre ces idées, avec moins de compétences spécialisées. Ils comprendront moins et la machine pourra donc être moins exploitée. Et s’ils arrêtent de l’utiliser, ils perdront eux-mêmes en compétences ; peut-être qu’un jour, on leur dira qu’on n’a même plus besoin d’eux. On descend ainsi peu à peu et l’on se retrouve avec une régression plutôt qu’une progression de nos capacités de pensée. Ce sont des questions qu’on s’est déjà posées dans beaucoup d’autres domaines, et ce sera la même chose dans les arts, la musique et les sciences humaines. Les gens qui sont à la frontière de ce qui est compréhensible et de ce que peut faire l’être humain permettent indirectement à l’humanité tout entière d’avancer. Si l’on enlève ces gens-là, c’est comme si l’on décidait, d’une certaine manière, que l’on est prêt à ce que le mouvement s’inverse et que la compréhension diminue.Hugo Duminil-Copin, de l’autre côté de la machine
70 ans après, la photographie d’un couple d’insurgés divise encore la Hongrie
Pourquoi la modernisation et l’hyperconnexion ont produit la génération la plus seule de l’histoire chinoise ?<br />